分布式认知工业互联网 2035数字议程的核心引擎与数据服务新范式
随着2035数字议程的深入推进,工业互联网正从连接与数据采集的初级阶段,迈向以智能决策和知识沉淀为特征的高级阶段。在这一演进中,分布式认知工业互联网与工业互联网数据服务成为两大重大议题,共同塑造未来工业的数字底座。
一、分布式认知工业互联网:从互联到智联的跃迁
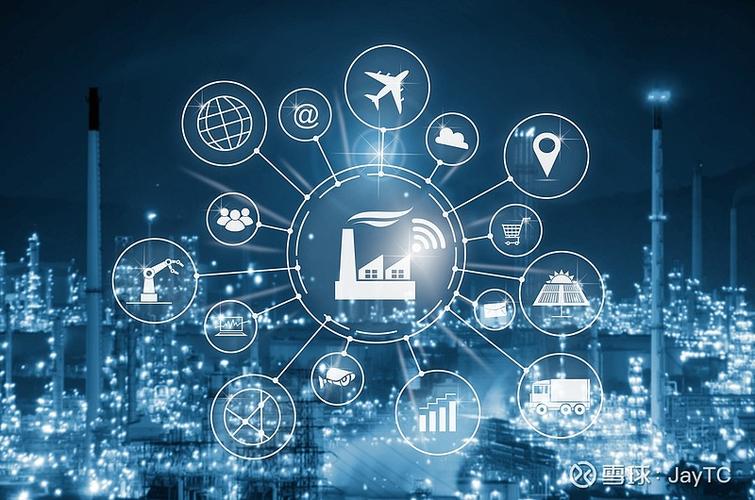
传统工业互联网侧重于设备连接、数据汇聚与远程监控,而分布式认知工业互联网则强调在边缘侧与云端协同中嵌入认知能力——即感知、理解、推理与决策。其核心特征是:
- 分布式智能:将AI模型下沉到边缘设备、产线节点,实现低延迟的本地推理与实时控制,同时与云端共享知识,形成“边缘认知+云上进化”的闭环。
- 认知协同:通过跨设备、跨产线、跨企业的语义互操作,使系统不仅交换数据,还能交换“理解”。例如,一台设备能将故障诊断知识以机器可读的形式传递给同类设备,实现群体智能。
- 知识自动化:将工业经验、工艺规则沉淀为可复用的认知模型,让工业互联网具备持续学习和自适应能力。
这一范式将推动工业生产从“自动化”走向“自主化”,为柔性制造、预测性维护、全流程优化提供关键技术支撑。
二、工业互联网数据服务:从资源到资产的转化
分布式认知的落地,离不开高质量的数据服务。2035数字议程下,工业互联网数据服务的内涵已从简单的数据存储与传输,扩展为覆盖数据全生命周期的价值服务体系:
- 数据治理与确权:建立工业数据分类分级标准,明确数据所有权、使用权与收益权,为数据流通奠定制度基础。
- 数据加工与知识提炼:通过数据清洗、标注、特征工程与知识图谱构建,将原始数据转化为可训练、可解释的认知资产。
- 数据服务API化:将数据能力封装为标准接口,使开发者、合作伙伴能按需调用数据服务,降低认知应用的开发门槛。
- 隐私计算与安全共享:联邦学习、可信执行环境等技术保障数据“可用不可见”,在保护商业机密的前提下释放数据协同价值。
三、二者融合:构建工业认知数据网络
分布式认知工业互联网与工业互联网数据服务并非孤立议题,而是相互依存、相互促进。数据服务为认知提供“燃料”,认知为数据服务定义“场景”。二者的融合将催生“工业认知数据网络”——一个覆盖全产业链的智能数据基础设施:
- 在工厂内,边缘认知节点实时处理数据,仅将高价值知识上传云端,减少带宽消耗;
- 在产业链上,企业间通过数据服务交换认知模型而非原始数据,实现知识共享与隐私保护的双赢;
- 在生态层面,形成可复用的工业认知组件库,加速中小企业智能化转型。
四、2035展望:关键行动建议
为实现2035数字议程目标,需在以下方面协同发力:
- 技术攻关:突破边缘智能芯片、工业知识图谱、跨域认知协同等核心技术;
- 标准先行:制定分布式认知接口规范、工业数据服务标准与互操作协议;
- 试点示范:在离散制造、流程工业等领域开展“认知工厂”试点,验证数据服务商业模式;
- 生态培育:构建工业认知开源社区,鼓励数据服务商与认知算法开发者协同创新。
分布式认知工业互联网与工业互联网数据服务,正在重新定义工业的智能边界。把握这一重大议题,就是把握2035数字议程的突破口,为制造强国与数字中国建设注入持久动力。
如若转载,请注明出处:http://www.dmyxp.com/product/57.html
更新时间:2026-11-21 16:56:47